Das Autograph
Vom handschriftlichen Original zur maschinenlesbaren Partitur — und was nötig wäre, um Echtheit direkt am Autograph zu prüfen
Zusammenfassung
Zwei Fotografien aus der Dropbox zeigen die ersten Seiten des Autographs „Mus. ms. autogr. Jos. Haydn 26“ — die Sinfonie Nr. 85 B-Dur „La Reine“ (Hob. I:85), 1. Satz (Adagio–Vivace), mit dem roten Besitzstempel der Preußischen Staatsbibliothek Berlin. Automatische Notenerkennung (OMR) scheitert an Handschriften des 18. Jahrhunderts; die Übertragung in moderne Notation erfolgte daher KI-gestützt Takt für Takt. Für eine Echtheitsprüfung direkt am Autograph skizzieren wir zwei komplementäre Wege — musikalischer Stil und Schriftduktus — samt Abschätzung des Datenbedarfs.
1. Die Quelle
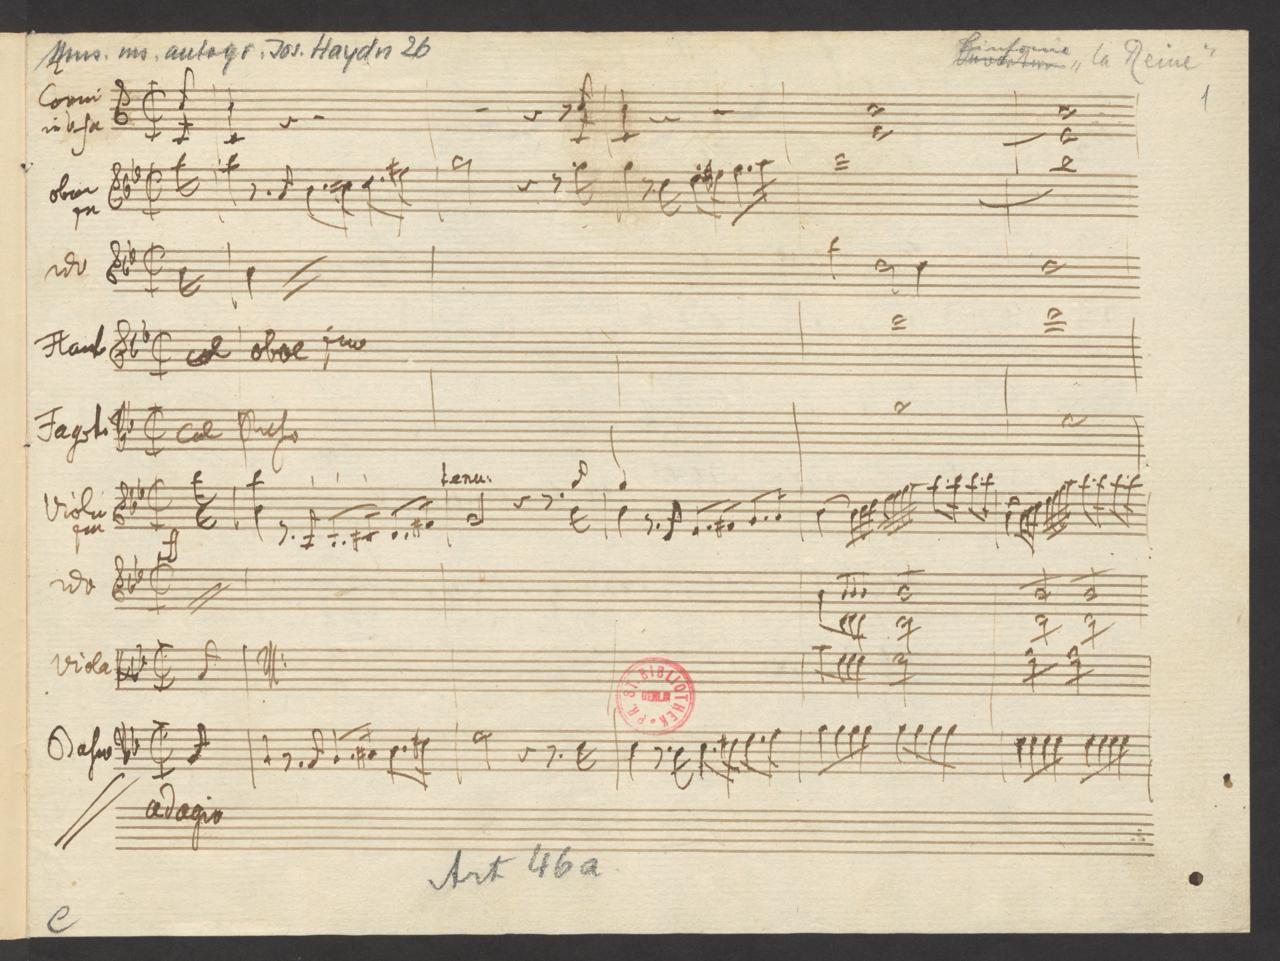
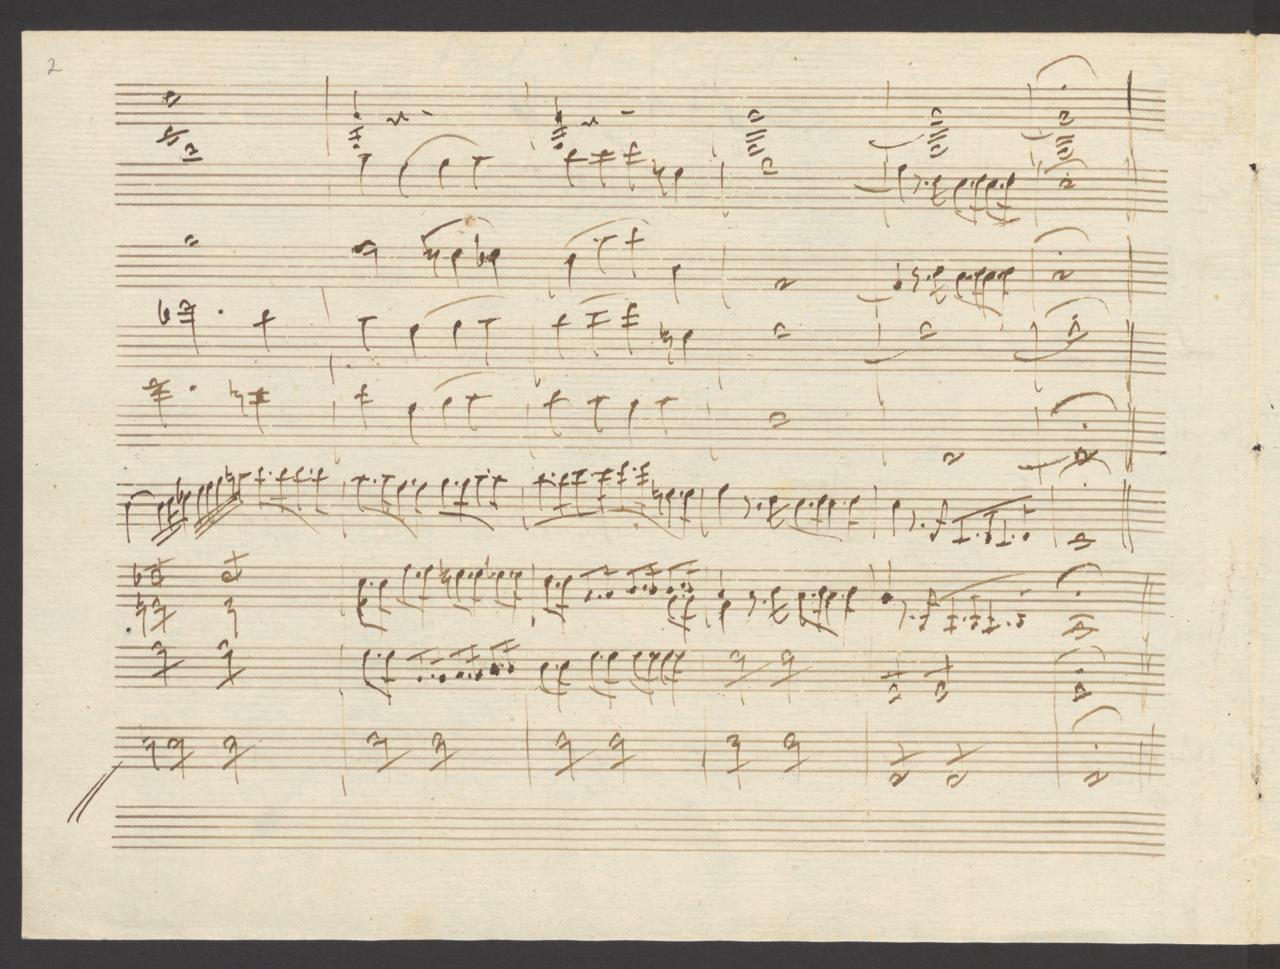
Die Sinfonie entstand 1785/86 für die Pariser Concerts de la Loge Olympique; ihren Beinamen verdankt sie Marie Antoinette. Das Autograph liegt heute in der Staatsbibliothek zu Berlin — der rote Rundstempel („Königl. Bibliothek“) auf Seite 1 ist auf den Fotos deutlich erkennbar.
2. Konvertierung in moderne Notation
2.1 Versuch mit automatischer Notenerkennung (OMR)
Vor der manuellen Übertragung wurden verfügbare Open-Source-OMR-Werkzeuge recherchiert und getestet:
| Werkzeug | Ansatz | Ergebnis auf dem Autograph |
|---|---|---|
| oemer 0.1.8 | Deep-Learning-Pipeline (UNet-Segmentierung → MusicXML) | Gescheitert — 1. Lauf: Timeout nach 9,5 min CPU-Inferenz; 2. Lauf: vom Kernel beendet (Out-of-Memory bei 7 GB RAM). Modell zudem auf Druckbild trainiert. |
| Audiveris | Klassische + ML-Symbolerkennung | Ungeeignet — laut Hersteller 80–90 % Genauigkeit bei sauberen Drucken; Handschrift und dichte Orchesterpartituren reduzieren die Erkennung drastisch. |
| homr | Transformer-OMR für Kamerafotos | Ungeeignet — für modernen Notendruck konzipiert. |
| KI-Transkription (dieses Projekt) | Bildaufbereitung (Pillow: Zeilen-Crops, 3×-Vergrößerung, Autokontrast) → multimodales Sprachmodell liest Takt für Takt → **kern → Verovio-Notensatz |
Funktioniert — Lesefassung unten; in Fassung 2 gegen den kritischen Text kollationiert (Abschnitt 2.4). |
Fazit der Recherche: OMR für historische Handschriften ist ein offenes Forschungsproblem — aktuelle Arbeiten behelfen sich mit synthetischen Trainingsdaten, veröffentlichte Systeme zielen fast ausschließlich auf Druckbild. Für Autographe des 18. Jahrhunderts ist der derzeit gangbare Weg eine KI-gestützte oder menschliche Transkription mit anschließendem maschinellem Notensatz.
2.2 Haydns Kürzelschrift — der Schlüssel zu den übrigen Stimmen
Beim zeilenweisen Lesen des Autographs zeigt sich, warum die Partitur auf den ersten Blick „leer“ wirkt: Haydn hat die meisten Stimmen gar nicht ausgeschrieben, sondern in der für ihn typischen Kürzelschrift notiert:
| Stimme | Notat im Autograph | Bedeutung |
|---|---|---|
| Flauto | „col Oboe 1mo“ | spielt durchgehend mit der 1. Oboe |
| Fagotti | „col Basso“ | spielen durchgehend mit der Basslinie |
| Violino II | „//“-Striche | unisono mit Violino I (T. 1–3); eigenes Material erst ab T. 4 |
| Viola | „unis.“ | mit dem Basso (T. 1–3); eigene Repetitionsfigur ab T. 4 |
Nur Violino I, Basso und punktuell die Oboen/Hörner tragen ausgeschriebene Substanz — ein charakteristisches Arbeitsökonomie-Merkmal echter Haydn-Autographe (und damit selbst ein paläographisches Echtheitsindiz, siehe Abschnitt 3).
2.3 Lesefassung: der komplette Ausschnitt in moderner Notation
Beide fotografierten Seiten (11 Takte Adagio), alle neun Systeme, Kürzel aufgelöst — Flöte und Fagotte sind ausgeschrieben, Violino II/Viola in den Unisono-Takten ebenso:
Editorischer Hinweis (Fassung 2, kollationiert): Die erste Lesefassung entstand allein aus den Fotos
(1280 px) und enthielt Rhythmusfehler — insbesondere wurden die 32stel-Läufe der Takte 4–6
als punktierte Sechzehntel-Paare gelesen, der Sechzehntel-Auftakt fehlte, und einzelne Tonhöhen der
Leitton-Paare (a–b, cis–d, fis–g) waren falsch. Diese Fassung ist gegen den kritischen Text von
H. C. Robbins Landon (LilyPond-Edition T. Lanfear, IMSLP #790985) und das RISM-Incipit
(Quelle 127189) Takt für Takt kollationiert. Hörner klingend notiert.
Quelle als **kern: data/autograph/hob_I_85_adagio_fullscore.krn
(generiert von build_fullscore_kern.py).
2.4 Lessons learned: wie man die Übertragung verbessert
Der Nutzer-Befund „aus 32steln wurden 16tel“ war korrekt und zeigt die Grenzen einer Einzelbild-Transkription. Der verbesserte Workflow, mit dem Fassung 2 erstellt wurde — und der sich auf beliebige Autograph-Seiten übertragen lässt:
| Maßnahme | Konkret | Wirkung |
|---|---|---|
| 1. Autoritative Referenz suchen | RISM-Incipit (maschinenlesbarer Plaine&Easie-Code der Anfangstakte) + kritische Edition als LilyPond-Quelltext (Robbins Landon / Lanfear) | Exakte Töne/Rhythmen statt Schätzung; deckte Auftakt, 32stel und Tonhöhenfehler auf |
| 2. Bessere Vorlage | Statt Handy-Fotos (1280 px) hochauflösende Bibliotheks-Digitalisate verwenden (Staatsbibliothek Berlin, IIIF) | Dritte Balken (32stel), Doppelpunktierungen und Vorzeichen werden erst ab ~300 dpi zuverlässig lesbar |
| 3. Takt-für-Takt-Kollation | Jeden Takt einzeln gegen die Referenz prüfen; Partitur skriptgesteuert generieren
(build_fullscore_kern.py mit Takt-Summen-Checks) |
Fehler bleiben lokal und reproduzierbar korrigierbar, kein stilles Fortpflanzen |
| 4. Unabhängige Zweitlesung | Zwei getrennte Transkriptionsdurchgänge (oder Modelle), anschließend Diff | Systematische Lesefehler einer einzelnen Passage fallen auf |
3. Echtheitsprüfung am Autograph: zwei Wege
3.1 Weg A — musikalischer Stil (was der Haydn Analyzer heute tut)
Nach der Transkription läuft die bestehende Pipeline: **kern → 70 stilometrische Merkmale
(Harmonik, Melodik, Rhythmik, Struktur) → XGBoost-Klassifikator. Der Weg prüft, ob die Musik nach
Haydn klingt — er erkennt Stilkopien nicht, wohl aber Fehlzuschreibungen fremder Werke (klassisches Beispiel:
die „Haydn“-Streichquartette op. 3, heute Roman Hofstetter zugeschrieben).
3.2 Weg B — Schriftduktus (Paläographie, neu)
Ein Autograph trägt aber ein zweites, unabhängiges Signal: die Handschrift selbst. Haydns Notenschrift hat individuelle, schwer imitierbare Züge — die Form der Viol- und Bassschlüssel, der Ansatz der Notenhälse, die Neigung der Balken, die Gestalt der Pausen und Bogenführung, dazu Gewohnheiten wie das „In Nomine Domini“ am Satzanfang und „Laus Deo“ am Schluss. Maschinell ist das ein Writer-Identification-Problem: ein CNN (bzw. Siamese-Netz) lernt aus kleinen Bildausschnitten („Patches“ einzelner Systeme oder Symbole), Schreiberhände zu unterscheiden — Haydn gegen seine Kopisten (allen voran Johann Elssler, dessen Abschriften häufig mit Autographen verwechselt werden), gegen Zeitgenossen und gegen spätere Fälschungen.
3.3 Wie viele Daten bräuchten wir?
| Ansatz | Minimal (Machbarkeitsnachweis) | Robust (publizierbar) | Verfügbare Quellen |
|---|---|---|---|
| A: Stil-Klassifikation (symbolisch) | ~20 Werke pro Klasse — entspricht dem heutigen Korpus (20 Werke); Kreuzvalidierung bleibt wacklig | 100–200 Haydn-Werke + ebenso viele Kontrastwerke (Mozart, Beethoven, M. Haydn, Pleyel, Vanhal, Hofstetter); damit sind in der Literatur ~85–95 % Trefferquote realistisch | KernScores/Humdrum (Quartette, Sinfonien, Sonaten), RISM-Incipits, MuseData |
| B: Schrift-Identifikation (Bild) | ~30–50 beglaubigte Autograph-Seiten Haydn + gleich viel von Kopisten/Zeitgenossen; patch-basiert ergibt das mehrere tausend Trainingsbeispiele (1 Seite ≈ 10–12 Systeme ≈ 100+ Symbol-Patches) | 200–500 Seiten Haydn quer durch alle Schaffensperioden (die Hand altert!) + Negativkorpus: Elssler-Abschriften, weitere Kopisten, M. Haydn, Fälschungen; Transfer-Learning ab ImageNet/Handschrift-Modellen senkt den Bedarf deutlich | Staatsbibliothek Berlin (digitalisierte Haydn-Autographe), Nationalbibliothek Széchényi Budapest (Esterházy-Bestand), British Library, Wienbibliothek |
Zur Einordnung: In der Writer-Identification-Forschung (ICDAR-Wettbewerbe) erreichen moderne Verfahren bei Texthandschriften über 90 % Genauigkeit mit nur 1–5 Seiten pro Schreiber — Notenhandschrift ist unübersichtlicher, bietet aber dafür hochrepetitive Symbole (tausende Notenköpfe pro Seite), was patch-basiertes Training begünstigt. Der Engpass ist nicht die Modellklasse, sondern ein beglaubigtes Trainingskorpus: jede Seite braucht eine gesicherte Zuschreibung als Label.
Quellen & Werkzeuge
- oemer — End-to-End OMR (Open Source): github.com/BreezeWhite/oemer
- Audiveris — Genauigkeit und Grenzen: audiveris.com
- OMR für reale Manuskripte mit synthetischen Daten (2026): arxiv.org/html/2606.09479
- End-to-End-OMR für ganze Seiten: arxiv.org/pdf/2405.12105
- Übersicht OMR-Datensätze (MUSCIMA++, DeepScores u. a.): apacha.github.io/OMR-Datasets
- Verovio Notensatz-Engine: verovio.org
- Digitalisierte Haydn-Autographe: digital.staatsbibliothek-berlin.de